Agents.md aiuto oppure ostacolo?
Paolo Volterra 
La ricerca analizza l’efficacia dei file di contesto come AGENTS.md, strumenti teoricamente progettati per guidare gli agenti di programmazione AI all’interno dei repository software. Attraverso il nuovo benchmark AGENTBENCH, gli studiosi hanno confrontato le prestazioni degli agenti utilizzando istruzioni scritte da sviluppatori, file generati da modelli linguistici (LLM) o nessuna guida. I risultati rivelano sorprendentemente che tali file spesso riducono il tasso di successo nelle attività di codifica, spingendo gli agenti verso un’esplorazione eccessiva e dispersiva. Oltre a complicare la risoluzione dei problemi, l’uso di questi contesti genera un aumento dei costi operativi superiore al 20%. In conclusione, gli autori suggeriscono di limitare il contenuto dei file di contesto ai soli requisiti essenziali, sconsigliando per ora l’uso di guide generate automaticamente.
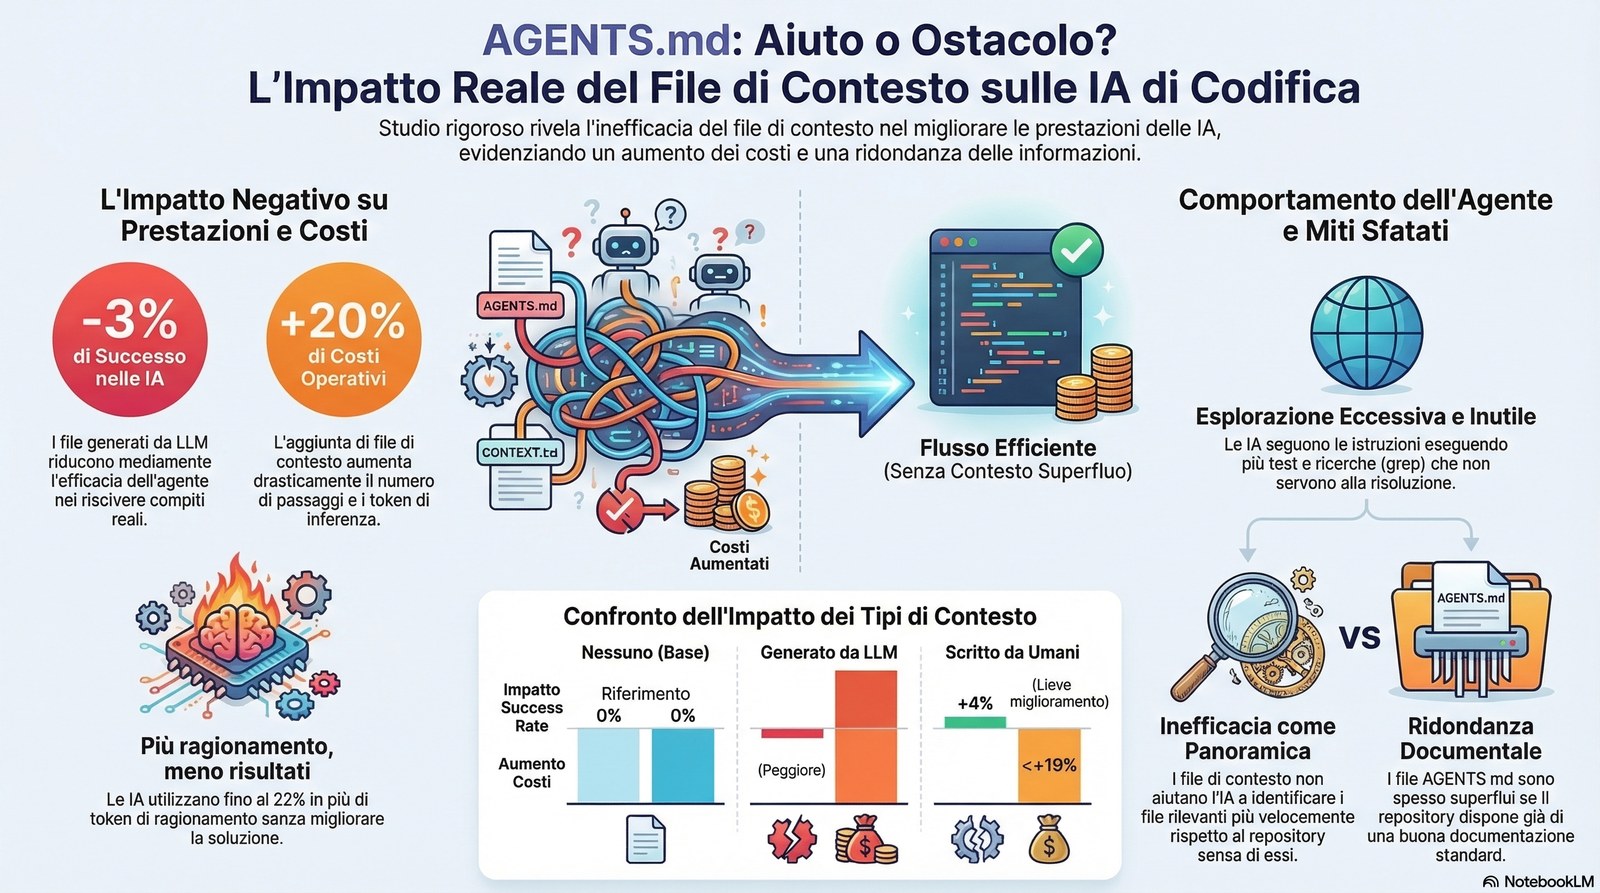
Il paper “Evaluating AGENTS.md: Are Repository-Level Context Files Helpful for Coding Agents?” mette in discussione una pratica che nel mondo degli agenti AI sta diventando quasi dogmatica: aggiungere file di contesto tipo AGENTS.md o CLAUDE.md nei repository.
I file di contesto per agenti (AGENTS.md) migliorano davvero le prestazioni degli agenti di coding? O sono solo una nuova moda della community AI?
Questo paper è un piccolo segnale di maturazione dell’AI engineering. All’inizio si pensava: più contesto = meglio.
Ora si scopre meno contesto ma più rilevante = meglio. È esattamente il principio del signal-to-noise ratio.
Gli autori testano la cosa con un benchmark chiamato AGENTBENCH. Caratteristiche:
138 task reali
da 12 repository Python
presi da issue GitHub reali
con context file scritti dagli sviluppatori
Ogni task ha:
repository
issue
patch corretta
test suite per verificare la soluzione.
Gli agenti lavorano in tre condizioni. Il risultato:
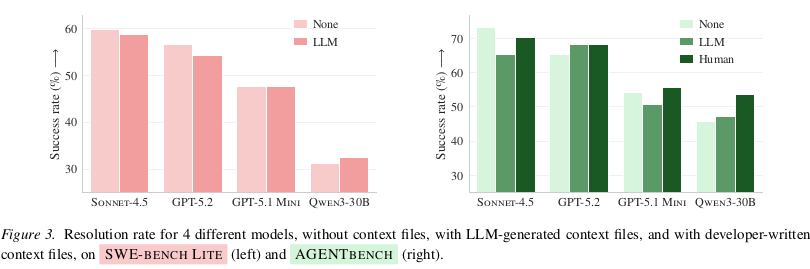
scenario risultato senza context baseline context LLM -3% performance context umano +4% performance
Quindi context file automatici peggiorano le prestazioni. E peggiorano anche il costo. Con context file:
più reasoning
più tool calls
più esplorazione del repo
Effetto:
+20–23% costo LLM
più passi di reasoning
più chiamate a test e grep.
Il motivo è molto interessante: gli agenti seguono troppo alla lettera le istruzioni.
Quando trovano AGENTS.md:
eseguono più test
leggono più file
esplorano più directory
usano più tooling.
Quindi le istruzioni diventano overhead cognitivo. I context file NON aiutano a trovare il codice. Uno dei presunti vantaggi era aiutare l’agente a capire la struttura del repo.
Ma i test mostrano che gli agenti non trovano i file rilevanti più velocemente e con context file spesso impiegano più passi.Se si elimina tutta la documentazione del repo, allora i context file diventano utili perchè sostituiscono README e docs.
Quindi funzionano solo quando la documentazione è scarsa; i context file dovrebbero essere minimali.
Solo comandi di build, test runner, tool da usare; NON overview, directory tree o spiegazioni lunghe.
Il punto chiave del paper è che AGENTS.md prova a risolvere un problema reale, ma con lo strumento sbagliato. Il problema esiste davvero: quando un agente entra in un repository grande, non conosce la struttura del codice, i comandi di build, i test o i tool specifici del progetto. Gli sviluppatori quindi cercano di “aiutarlo” con un file di contesto. L’idea è: se gli diamo una spiegazione del repository, l’agente lavorerà meglio.
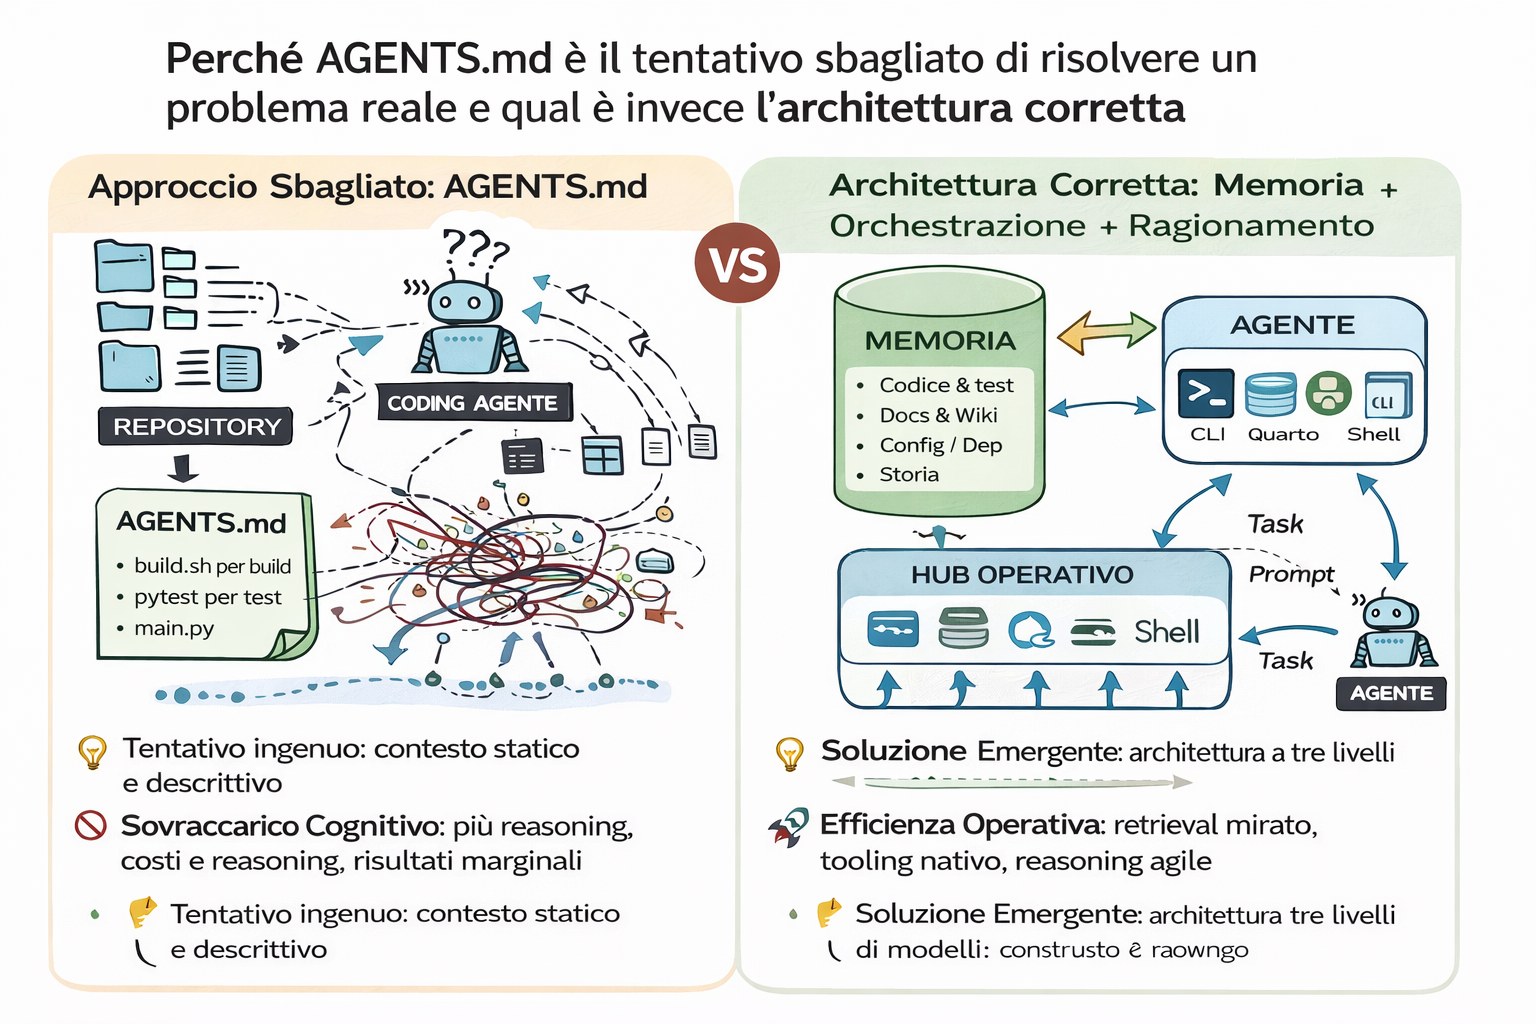
Il paper dimostra però che questa soluzione è concettualmente fragile. Un file come AGENTS.md è documentazione statica, mentre il problema dell’agente è operativo e dinamico. L’agente non ha bisogno di leggere una descrizione del repository; ha bisogno di interagire con esso, esplorarlo, eseguire comandi, osservare risultati e aggiornare le proprie ipotesi. Quando gli si fornisce un contesto lungo e descrittivo, succede una cosa prevedibile: l’agente segue le istruzioni, ma questo aumenta il numero di passi, il reasoning e i costi senza migliorare molto il risultato. In altre parole, il file di contesto aggiunge rumore cognitivo. Il paper mostra proprio questo: più contesto porta a più esplorazione e più reasoning, ma non a soluzioni migliori.
Il motivo è strutturale. Un agente funziona attraverso un ciclo di percezione e azione: osserva lo stato del sistema, compie un’azione (leggere un file, cercare nel codice, eseguire test), osserva il risultato e aggiorna il piano. Questa è la stessa logica dei sistemi autonomi o dei robot. Un documento statico non si integra bene con questo ciclo. È come dare a un robot un manuale invece di sensori. Il robot leggerà il manuale, ma continuerà comunque a esplorare l’ambiente per capire cosa fare.
Il vero problema quindi non è “mancanza di contesto”, ma mancanza di accesso strutturato alla conoscenza del sistema. AGENTS.md cerca di comprimere tutta questa conoscenza in un file Markdown. Ma un repository reale contiene molte forme diverse di informazione: codice, test, documentazione, script, configurazioni, storia delle modifiche, dipendenze. Mettere tutto questo in un unico file significa creare un riassunto incompleto e spesso ridondante rispetto alla documentazione già presente. Il paper conferma proprio questo: quando il repository ha già README e documentazione, il context file diventa quasi inutile.
L’architettura corretta è diversa. Invece di comprimere il contesto in un file statico, bisogna separare memoria, orchestrazione e ragionamento. Prima serve una memoria strutturata del sistema: un luogo dove le informazioni del repository sono indicizzate e recuperabili in modo mirato. Poi serve un hub che orchestri l’accesso a queste informazioni e agli strumenti operativi (CLI, test runner, build system, database). Infine serve il livello di ragionamento dell’agente che interroga questa infrastruttura quando serve, invece di ricevere tutto il contesto in anticipo.
Questo porta a un’architettura a tre livelli. Il primo livello è la memoria, dove il contenuto del repository e della documentazione viene indicizzato e reso interrogabile. Il secondo livello è l’hub operativo, che collega l’agente agli strumenti del sistema: comandi CLI, file system, database, test. Il terzo livello è l’agente stesso, che usa queste capacità per eseguire un ciclo iterativo di osservazione e azione. In questo modello il contesto non è un documento statico, ma qualcosa che viene recuperato solo quando serve.
Il vantaggio è duplice. Da un lato si riduce il rumore informativo, perché l’agente riceve solo le informazioni rilevanti per il task corrente. Dall’altro si migliora la scalabilità: lo stesso agente può lavorare su repository molto grandi o su sistemi complessi senza dover leggere lunghi file di contesto. In pratica si passa da un modello document-centric a un modello system-centric.
Per questo AGENTS.md è una soluzione temporanea: è il tentativo di adattare gli agenti a un paradigma di documentazione tradizionale. L’architettura emergente invece tratta l’agente come un operatore dentro un sistema informativo più grande. In questo senso il pattern corretto non è “scrivere meglio il file AGENTS.md”, ma costruire un’infrastruttura dove la conoscenza del sistema è distribuita tra memoria, strumenti e orchestrazione. È esattamente il tipo di architettura modulare che si ottiene separando memoria, hub e livello di ragionamento.
Pubblicato in origine su Substack il 5 marzo 2026.
Torna in cimaVedi anche
- ChatGPT & Reverse EngineeringRicavare i valori di un grafico da un’immagine con un LLM: come far lavorare in gruppo modello, OCR e Python.
- Platone e l’intelligenza artificialeConoscenza, rappresentazione della realtà, apprendimento e verità
- Il ruolo dell’intelligenza artificialeL’intelligenza artificiale è entrata negli uffici più velocemente di quanto molte organizzazioni abbiano avuto il tempo di prepararsi.