Il punto di partenza: poster 12 della Challenge BdI
La Challenge come agenda-setting
L’Innovation Data Challenge 2026, organizzata da Banca d’Italia e Central Bank of Ireland in collaborazione con sette università, non è un concorso accademico generico. È un dispositivo istituzionale: attraverso la selezione e la pubblicazione dei poster selezionati, le banche centrali indicano quali problemi considerano rilevanti, quali metodi considerano maturi e quali competenze diventano strategiche per il sistema bancario.
Il messaggio sottostante ai tredici poster è coerente: l’intelligenza artificiale bancaria seria non è l’assistente che riassume testi, ma l’infrastruttura analitica che trasforma dati granulari in segnali azionabili — su frodi, resilienza, rischio sistemico, early warning, pagamenti.
Il poster 12 — Liquidity Dynamics
Il poster 12 affronta la domanda: i dati transazionali possono identificare le PMI finanziariamente fragili prima che la fragilità emerga nei bilanci?
Dati usati: transazioni PMI e bilanci 2024–2025 (dati sintetici IT–IE).
Definizione di distress (variabile dipendente, binaria): almeno una delle seguenti condizioni è vera —
\[\text{ICR} < 1{,}5 \quad \text{OR} \quad \text{Current Ratio} < 1 \quad \text{OR} \quad \text{OCF} < 0\]
Tre indicatori transazionali (feature engineering dal conto corrente):
| Liquidity Buffer |
Saldo medio disponibile / uscite medie |
Liquidità corrente |
| Stress Frequency |
% giorni con saldo sotto soglia critica |
Frequenza tensione di cassa |
| Stress Severity Ratio |
Deficit medio nei giorni critici / saldo medio |
Intensità dello stress |
Modello: regressione logistica con variabili standardizzate.
Performance: AUC = 0,657 — statisticamente significativo, capacità di ordinare un’impresa distressed sopra una sana nel 66% dei casi.
Il passaggio chiave: i dati transazionali anticipano il bilancio. Non sostituiscono l’analisi economico-finanziaria, ma la rendono forward-looking: il segnale di fragilità emerge dai flussi di cassa prima di comparire nelle voci di stato patrimoniale.
Collegamento con altri poster della Challenge
Anche i poster 2 (LocalGLMnet per anomaly detection), 3 (Random Forest + Simulated Annealing per resilienza), 9 (early warning operativo con threshold latenza) e 11 (welfare costs dei payment glitches) condividono la stessa logica: trasformare dati grezzi in indicatori precoci di rischio. Il poster 12 è quello più direttamente collegabile al credito PMI e ai bilanci bancari.
Algoritmi dalla Challenge rilevanti per lo spinoff
Tre metodi del PDF meritano approfondimento perché danno l’idea di come costruire l’early warning, non solo di cosa misurare.
Regressione logistica per scoring di distress (poster 12)
La regressione logistica stima la probabilità che un’osservazione appartenga alla classe positiva (distress = 1):
\[P(\text{distress}_i = 1) = \frac{1}{1 + e^{-(\beta_0 + \beta_1 x_{1i} + \cdots + \beta_k x_{ki})}}\]
Vantaggi nel contesto bancario: - Coefficienti interpretabili: ogni \(\beta_j\) è il log-odds ratio — quanto cambia la probabilità di distress per una variazione unitaria di \(x_j\). - Output probabilistico: produce un score continuo [0,1] ordinabile per priorità di intervento. - Glass-box per compliance: l’esplicitezza dei coefficienti è compatibile con i requisiti di spiegabilità (SREP, Linee guida EBA su AI). - AUC come metrica: misura la capacità discriminante del modello senza dipendere dalla soglia di classificazione.
Limitazione principale: assume relazione lineare tra le feature trasformate e il log-odds. Non cattura interazioni complesse senza engineering esplicito delle feature.
È appropriata nel poster perché l’esito della singola impresa è binario e le osservazioni transazionali sono granulari. Non viene trasferita a questo studio: qui l’esito è un tasso regionale continuo, per cui si usano regressioni lineari e metriche di errore fuori campione.
LocalGLMnet — XAI con coefficienti variabili per osservazione (poster 2)
Il poster 2 propone un’alternativa al trade-off linearità/opacità: il LocalGLMnet, un framework “glass-box” in cui i coefficienti di regressione variano per singola osservazione.
\[\hat{y}_i = \sum_j \beta_j(\mathbf{x}_i) \cdot x_{ij}\]
dove \(\beta_j(\mathbf{x}_i)\) è stimato da una rete neurale che prende in input l’intero vettore \(\mathbf{x}_i\). Il risultato è un modello: - Non lineare nelle relazioni tra feature (la rete cattura interazioni) - Interpretabile localmente: per ogni osservazione \(i\), i coefficienti \(\beta_j(\mathbf{x}_i)\) hanno la stessa interpretazione di un modello lineare
Rispetto a SHAP/LIME (post-hoc, approssimazioni): LocalGLMnet è un modello intrinsecamente spiegabile, non una spiegazione aggiunta a posteriori. Per un ufficio compliance o risk management, la differenza è sostanziale.
Rilevanza per questo spinoff: se si disponesse di dati individuali PMI (es. integrazione Cerved × segnalazioni BdI), LocalGLMnet sarebbe il metodo naturale per un early warning che soddisfi i requisiti EBA sulla spiegabilità dei modelli di scoring.
Random Forest + Simulated Annealing per riduzione falsi positivi (poster 3)
Il poster 3 affronta il problema del “cry wolf crisis” nei sistemi di rilevamento anomalie: troppi allarmi generano rumore e riducono la capacità di intervento. La soluzione è:
- Random Forest / Gradient Boosting per la classificazione delle anomalie (segnale di base)
- Simulated Annealing per ottimizzare la soglia di allerta — l’algoritmo cerca la soglia che massimizza la funzione obiettivo (tipicamente F1-score o combinazione di precisione/richiamo) navigando lo spazio delle soluzioni con perturbazioni casuali accettabili con probabilità decrescente
\[T(t) = T_0 \cdot e^{-\lambda t}\]
L’analogia con il presente lavoro riguarda il controllo dei falsi segnali. Il simulated annealing non viene applicato: con 18 regioni e un solo anno di test, ottimizzare i pesi dello score produrrebbe un elevato rischio di overfitting.
| Dimensione Poster 12 (BdI) Questo spinoff |
Unità Singola impresa NUTS2 (18 regioni)
Dati input Transazionali real-time Segnalazioni bancarie aggregate
Distress ICR / current ratio / OCF Tasso sofferenze nette
Feature Liquidity Buffer, Stress Frequency, Stress Severity Leverage, MOL/Attivo (lag-1)
Metodo Logistic regression Benchmark dinamici e panel OLS
Metrica AUC MAE/RMSE fuori campione (2024) —————————————————————————————————————
Fonti dati:
Costruzione della variabile dipendente
Il tasso NPL è definito come:
\[\text{NPL rate}_{r,t} = \frac{\text{Sofferenze nette SNF}_{r,t}}{\text{Impieghi imprese}_{r,t}} \times 100\]
dove \(r\) = regione NUTS2, \(t\) = anno (snapshot dicembre).
Nota tecnica: TRI30211 (numeratore) usa SET_CTP=S11 (sole SNF), mentre TDB10224 (denominatore) usa SET_CTP=SBI25 (SNF + famiglie produttrici). La leggera sovrastima del denominatore produce una lieve sottostima del tasso, uniforme tra regioni — non altera la variazione cross-regionale.
Il rapporto NPL/impieghi normalizza le sofferenze per la dimensione del mercato creditizio regionale. Si usano snapshot di dicembre per evitare che frequenze diverse delle fonti introducano confronti infrannuali. Il mismatch S11/SBI25 impone di interpretare il risultato come proxy, non come NPL ratio regolamentare.
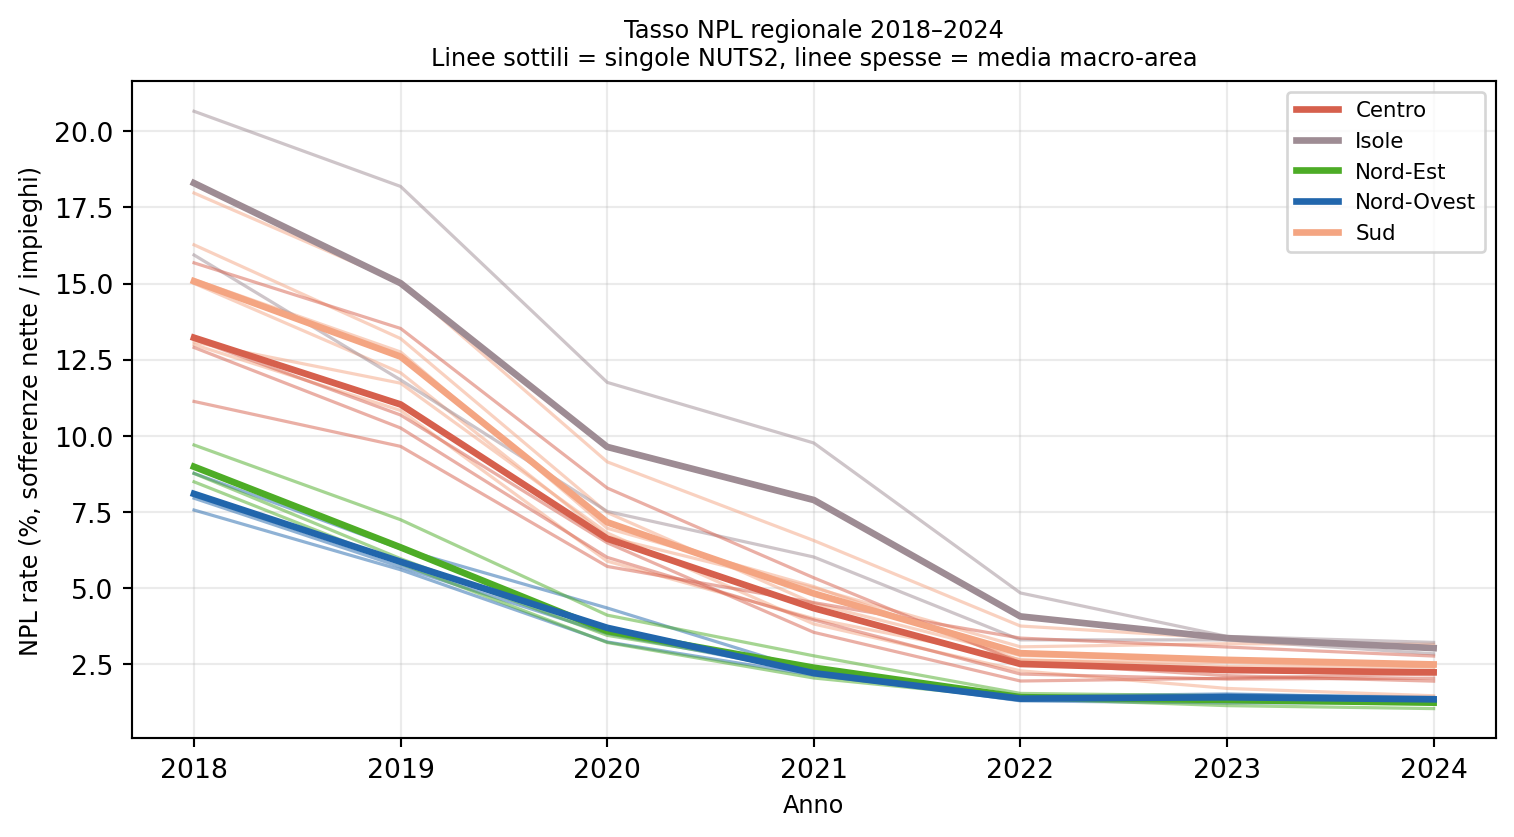
Il trend decrescente fino al 2023 riflette il cleanup bancario post-crisi. Nel 2024 la discesa rallenta nettamente: questo cambio di regime rende particolarmente severo il test fuori campione.
Disegno predittivo e modelli
Il panel predittivo associa l’esito \(NPL_{r,t}\) esclusivamente a informazioni disponibili in \(t-1\). La stima usa gli anni 2019–2023; il 2024 è tenuto completamente fuori campione.
Il lag impone l’ordine informativo necessario a un early warning: le caratteristiche 2023 possono spiegare o prevedere il 2024, non il contrario. Questa scelta elimina il leakage presente quando il CdL/VA 2024 veniva associato agli anni precedenti. Il CdL/VA resta disponibile soltanto come confronto descrittivo esterno.
Si confrontano quattro specificazioni: persistenza ingenua, autoregressione stimata, autoregressione con variabili di struttura e modello dinamico con effetti fissi regionali.
\[ \begin{aligned} \text{Naive:}\quad &\widehat{NPL}_{r,t}=NPL_{r,t-1} \\ \text{M0:}\quad &NPL_{r,t}=\alpha+\rho NPL_{r,t-1}+\varepsilon_{r,t} \\ \text{M1:}\quad &NPL_{r,t}=\alpha+\rho NPL_{r,t-1}+\beta_1 Lev_{r,t-1}+\beta_2 MOL_{r,t-1}+\varepsilon_{r,t} \\ \text{M2:}\quad &NPL_{r,t}=\alpha_r+\rho NPL_{r,t-1}+\beta_1 Lev_{r,t-1}+\beta_2 MOL_{r,t-1}+\varepsilon_{r,t} \end{aligned} \]
Il tasso NPL è fortemente persistente. Prima di attribuire capacità anticipatrice a leverage e MOL/Attivo bisogna verificare se migliorano una previsione basata sul solo NPL precedente. La regola naive è il benchmark operativo più difficile da battere quando la serie si stabilizza.
Le dummy NUTS2 controllano caratteristiche regionali costanti e non osservate. Sono utili come diagnostica within-region, ma con appena cinque anni di training un modello dinamico FE è esposto a Nickell bias; non viene quindi interpretato causalmente.
Gli errori sono clusterizzati per NUTS2 per ammettere eteroschedasticità e correlazione seriale all’interno della stessa regione. Con 18 cluster l’inferenza resta approssimata e i p-value vanno letti con cautela.
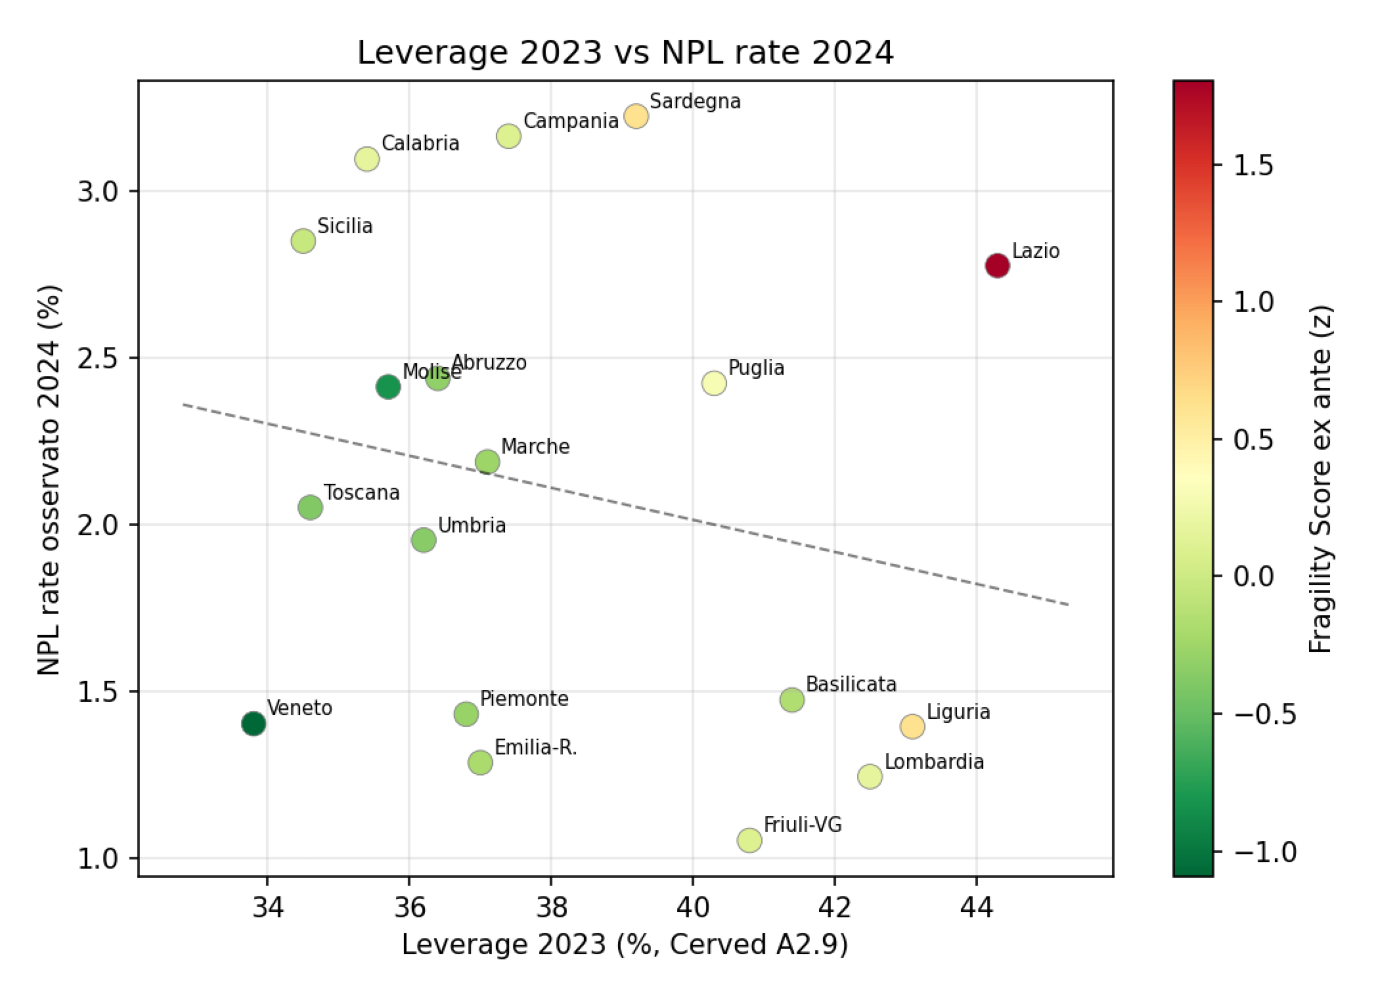
Il coefficiente di \(NPL_{t-1}\) è elevato e significativo. Una volta controllata questa persistenza, leverage e MOL/Attivo non sono significativi né nel modello pooled né nel modello FE. Il precedente risultato sul leverage dipendeva quindi dall’omissione della dinamica propria del tasso NPL.
Backtest temporale 2024
Il 2024 non partecipa alla stima: simula una previsione reale prodotta a fine 2023. MAE misura l’errore medio assoluto; RMSE penalizza maggiormente gli errori grandi. È una verifica più pertinente dell’R² in-sample per stabilire se esiste capacità di early warning.
La persistenza naive ottiene RMSE 0,192. M1, che aggiunge leverage e MOL/Attivo, raggiunge 0,746: un errore quasi quattro volte superiore. Anche M2-FE (0,455) non batte il benchmark. I modelli stimati sottoprevedono sistematicamente il 2024 perché apprendono la forte discesa 2019–2023, mentre nel test il tasso si stabilizza. Non emerge quindi evidenza che le variabili di bilancio migliorino la previsione annuale del tasso NPL.
Estensioni testate a h=1: nessuna salva il modello
Prima di concludere che mancassero variabili, sono state testate altre due estensioni sullo stesso orizzonte a un anno: l’aggiunta di due feature regionali costruite ad hoc (HHI bancario su sportelli e quota di credito Costruzioni+Immobiliare, come proxy di concentrazione del mercato e di esposizione settoriale) e una riformulazione del modello in variazioni anno su anno invece che in livelli.
| M1 (livelli, leverage+MOL/Attivo) |
0,746 |
baseline già scartata |
| M1 + HHI regionale + quota Costruzioni/Immobiliare |
0,724 |
nessun miglioramento, variabili non significative (p=0,186 e p=0,523) |
| Modello in differenze (momentum del calo) |
1,142 |
peggiore di tutti |
Il fatto che aggiungere due covariate economicamente sensate non sposti il risultato, e che passare ai livelli-in-differenze peggiori ulteriormente, indica che il problema non è l’assenza di una feature dimenticata. Il tasso NPL regionale a un anno si comporta empiricamente come un processo vicino a un random walk: il valore di oggi resta il miglior predittore di quello di domani, e ogni tentativo di aggiungere struttura introduce più errore di stima di quanto tolga di bias.
Cambiare orizzonte: a tre anni il modello vince
Se il problema è che a un anno il tasso si muove troppo poco perché la struttura di bilancio conti qualcosa rispetto al rumore, la domanda naturale è: cosa succede a un orizzonte più lungo, dove il livello si è spostato abbastanza da lasciare margine ai fondamentali? Ripetendo lo stesso confronto (persistenza vs. modello con leverage e MOL/Attivo) a 2 e 3 anni di distanza:
| 1 anno |
90 |
0,192 |
0,746 |
persistenza (3,9×) |
| 2 anni |
72 |
0,537 |
1,248 |
persistenza (2,3×) |
| 3 anni |
54 |
2,519 |
1,267 |
modello (2,0×) |
A tre anni il margine operativo lordo su attivo diventa altamente significativo (coefficiente -0,304, p=0,001): più redditività oggi, meno sofferenze tra tre anni — un ritardo economicamente sensato, coerente con un canale in cui la redditività condiziona la capacità di servizio del debito nel medio periodo, non nel mese successivo.
Con soli sei anni di dati Cerved (2018–2023), il test a h=3 dispone di un solo anno di verifica fuori campione (2024, da un’origine 2021) e 54 osservazioni di stima. È un segnale promettente e coerente con l’intuizione economica, non ancora un risultato validato con vera cross-validation temporale. Andrà riconfermato quando saranno disponibili più anni di indicatori Cerved.
Implicazione per il progetto: l’orizzonte corretto per un early warning basato su questi dati non è un anno ma due-tre anni. Le sezioni seguenti (score composito, mappa) restano costruite sull’orizzonte a un anno per coerenza con la pipeline esistente; la revisione a orizzonte 2-3 anni è il prossimo passo naturale (v. Sviluppi possibili).
Score composito di fragilità ex ante
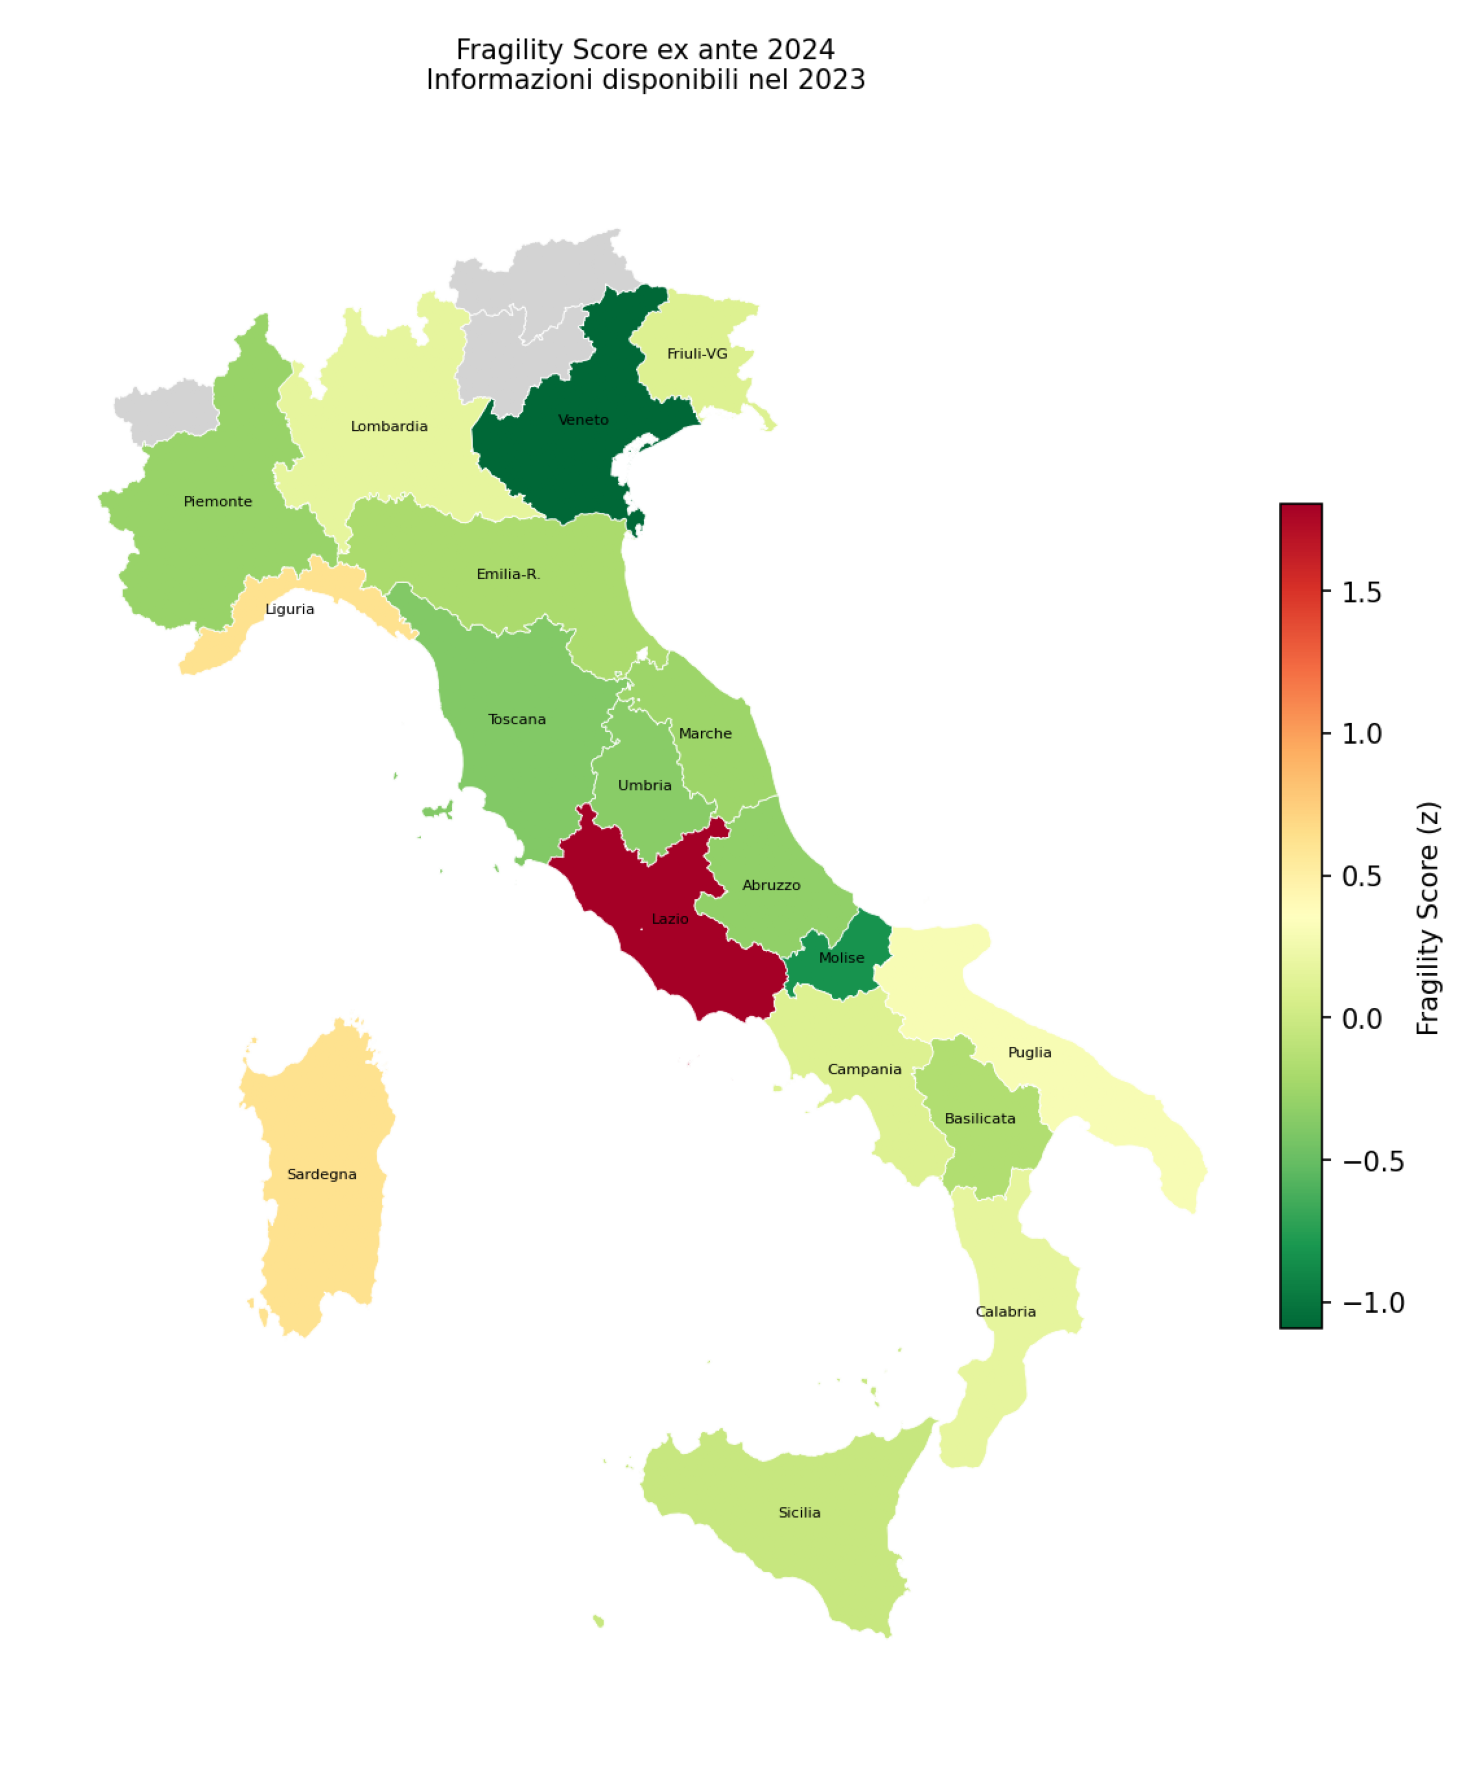
Per sintetizzare le tre dimensioni disponibili a fine 2023, lo score destinato al 2024 è:
\[\text{Fragility}_{r,2024} = \frac{1}{3} \left[ z(\text{NPL}_{r,2023}) + z(\text{Leverage}_{r,2023}) - z(\text{MOL/Attivo}_{r,2023}) \right]\]
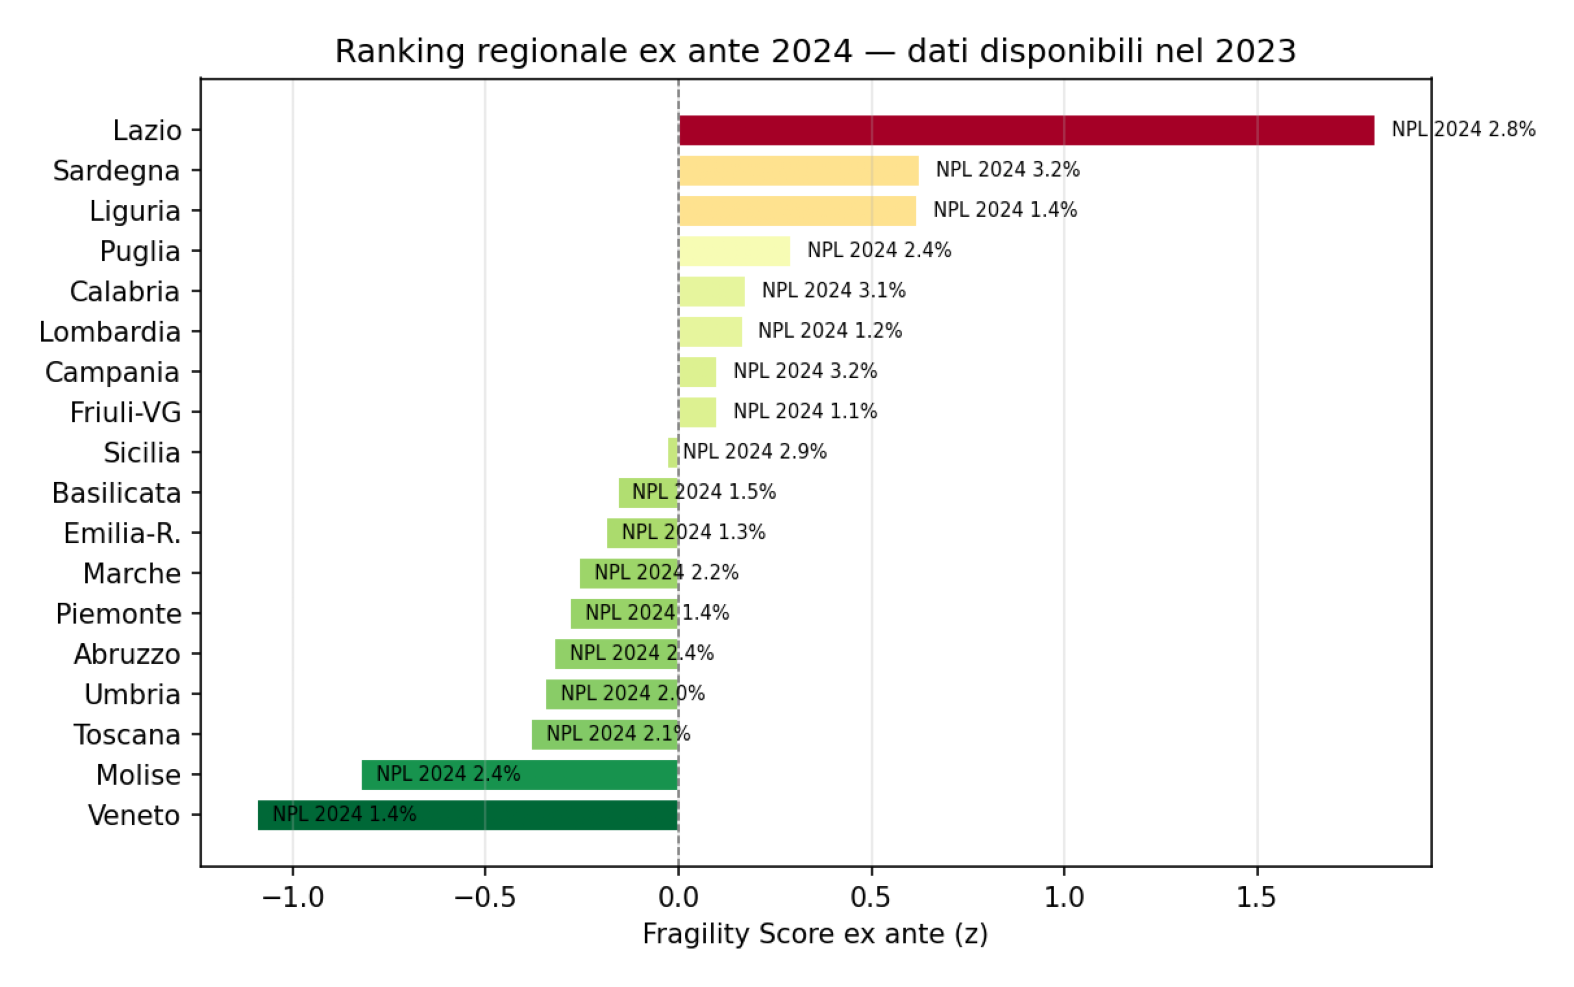
Gli z-score rendono confrontabili variabili con scale diverse; i segni incorporano la direzione economica attesa. Tutte le componenti precedono l’esito 2024, che resta escluso dalla costruzione. I pesi uguali sono trasparenti ma non stimati: lo score ordina esposizioni strutturali e non rappresenta una probabilità calibrata di distress.
La correlazione di rango tra score e NPL osservato nel 2024 è 0,282: positiva ma debole. Lo score deve quindi essere considerato esplorativo.
Conclusioni
Il poster 12 mostra che sequenze transazionali granulari possono anticipare il distress della singola PMI. Questo studio verifica se la stessa intuizione generale sopravvive usando rilevazioni annuali aggregate regionali. Non replica quindi la tecnica originale: ne costruisce un’analogia più debole e la sottopone a backtest.
Il risultato principale a un anno è negativo ma informativo. Il tasso NPL precedente spiega quasi tutta la capacità di ordinamento regionale; leverage e MOL/Attivo non aggiungono coefficienti significativi. Nel 2024 la persistenza naive ottiene RMSE 0,192, contro 0,746 del modello strutturale e 0,455 del modello dinamico FE — un divario di quasi quattro volte, non un pareggio. Aggiungere concentrazione bancaria regionale ed esposizione settoriale a Costruzioni/Immobiliare non lo colma (0,724); nemmeno modellare la variazione anno su anno invece del livello (1,142). Il tasso NPL regionale a un anno si comporta come un processo vicino a un random walk: non esiste, su questo campione e a questo orizzonte, evidenza sufficiente per qualificare le variabili di bilancio come leading indicator.
Cambiando orizzonte, il quadro si ribalta. A tre anni di distanza il modello con leverage e MOL/Attivo batte la persistenza di un fattore due (RMSE 1,267 contro 2,519), e il margine operativo lordo su attivo diventa un predittore altamente significativo (p=0,001). Il risultato si basa su un solo anno di verifica fuori campione e va quindi trattato come promettente, non consolidato — ma sposta la domanda di fondo del progetto: non “i fondamentali di bilancio prevedono le sofferenze bancarie regionali”, ma “a quale orizzonte lo fanno”. La risposta emersa oggi è due-tre anni, non uno.
Lo score ex ante identifica il Lazio come regione maggiormente esposta secondo la combinazione scelta, ma la correlazione di rango con l’NPL 2024 è soltanto 0,282 — costruito e validato sull’orizzonte a un anno che si è rivelato il meno promettente. Il prodotto finale resta oggi un indicatore esplorativo di fragilità territoriale, utile per formulare ipotesi e organizzare il monitoraggio, non un sistema validato di early warning né uno strumento di scoring delle singole PMI. Il prossimo passo naturale è ricostruirlo sull’orizzonte a tre anni, dove il segnale è più forte.
Trasparenza sull’uso dell’intelligenza artificiale
L’uso di strumenti di intelligenza artificiale generativa è dichiarato esplicitamente in quanto parte del processo di lavoro seguito nella redazione del presente documento. Tali strumenti sono stati impiegati a supporto della lettura, della sintesi, della riorganizzazione argomentativa e della revisione testuale, sempre nell’ambito di un processo pienamente controllato dall’autore.
La responsabilità per le fonti utilizzate, le analisi condotte, le verifiche effettuate, le interpretazioni proposte e le conclusioni formulate resta interamente in capo all’autore.
L’intelligenza artificiale è stata utilizzata come ambiente di supporto cognitivo ed editoriale, non come fonte primaria, autore autonomo o sostituto del giudizio critico.